들어가며: 에이전트는 우리가 제공하는 지식만큼만 똑똑하다
AI 에이전트를 사내 시스템에 연결하는 기업이 빠르게 늘고 있다. AI 모델의 성능은 계속 좋아지고 있고, 여러 도구를 활용해 실제 작업을 맡기는 일도 어렵지 않게 되었다. 그러나 사내 데이터를 다루는 순간 모델의 성능만으로 해결되지 않는 문제가 드러난다. AI는 데이터를 다룰 줄은 알지만 그 조직의 데이터가 어떻게 생겼는지, 지표를 어떻게 해석해야 하는지는 알지 못한다. 기업의 데이터베이스에서 에이전트로 매출을 조회하는 상황을 생각해 보자. AI는 SQL 자체는 잘 알고 있지만, 어떤 테이블에 매출이 담겨 있는지, 어떤 컬럼이 무슨 지표를 뜻하는지를 알아야 제대로 된 SQL을 만들 수 있다. 그런데 이 지식은 한곳에 모여 있지 않다. 테이블 구조는 메타데이터 카탈로그에, 지표 정의는 별도 문서와 코드 주석에 흩어져 있다. 시스템마다 접근 경로와 인증이 달라 에이전트가 이 지식을 읽으려면 도구를 하나씩 새로 만들어야 한다.
그렇다면 이 지식을 정해진 형식으로 한곳에 적어 두고 여러 에이전트가 제약 없이 재사용할 수는 없을까? 본 글에서는 이 질문의 해답으로 등장한 OKF(Open Knowledge Format)를 살펴보고, 이를 Agentic RAG와 결합해 사용하는 구체적인 방식을 다룬다.
1. 지식 탐색의 한계: 맹목적 주입과 기계적 분할
지금까지 AI에게 지식을 건네는 방식은 크게 두 가지였다.
하나는 전체 데이터를 컨텍스트에 그대로 밀어 넣는 방식이다. 지식의 양이 늘어나면 컨텍스트 창의 한계를 초과해 다 들어가지 못하고, 억지로 넣더라도 질문과 무관한 내용이 섞여 답변의 정확도가 떨어진다. 게다가 호출할 때마다 동일한 지식을 중복해서 주입해야 하니 비용도 그대로 누적된다.
다른 하나는 널리 쓰이는 벡터 기반의 RAG다. 문서를 정해진 크기로 잘라(chunking) 벡터로 임베딩한 뒤, 질문과 유사도가 높은 조각만 꺼내오는 방식이다. 하지만 자르는 위치가 규칙 기반으로 정해지기 때문에 문서가 어디서 끊길지 미리 예측할 수 없다. 표 헤더와 본문 내용이 서로 다른 조각으로 쪼개지기도 하고, 중요한 단서 조항이 본문과 분리되기도 한다. 이렇게 파편화된 조각만으로는 원래 문서가 무엇을 말하려 했는지 온전히 파악하기 어렵다. 한 문서에 맞춰 규칙을 수정하면 오히려 다른 문서의 문맥이 깨지는 악순환이 발생하기도 하며, 인덱싱 파이프라인과 벡터 DB 유지보수, 재임베딩 연산 비용은 계속 안고 가야 한다.
이러한 두 방식의 한계를 극복하기 위해 다양한 시도가 있었고, 본 글에서는 그중 지식을 미리 ‘개념 단위’로 정리해 두고 꺼내 쓰는 ‘LLM Wiki 패턴’의 한 예시를 살펴본다.
2. 자르지 않고 개념 단위로 묶기
새로운 접근은 에이전트가 매번 원문에서 답을 찾아내던 과정을 ‘잘 정리된 지식’으로 미리 분리하는 것에서 시작한다. 문서의 내용을 해석하는 작업은 데이터를 빌드하는 시점에 미리 끝내고, 질문을 받은 에이전트는 그 결과만 빠르게 읽는다. 정보를 프롬프트 안에서 매번 해석하지 않고 지식을 외부 공간에 두고 필요할 때마다 꺼내 쓴다는 의미에서 지식 오프로딩(Knowledge Offloading)이라고 부른다.
이때 문서는 ‘개념 단위’로 작성된다. 하나의 개념이 곧 하나의 문서가 되며, 해당 개념을 이해하는 데 필요한 모든 내용은 문서 안에 자연어로 담긴다. 사람의 판단 하에 문서의 경계를 명확히 정하므로, 기계적인 청킹으로 인해 문맥이 끊기거나 불필요한 정보가 섞여 들어가는 일이 발생하지 않는다. 또한 각 지식이 개별 파일로 존재하기 때문에 Git으로 변경 이력을 남기고 코드 리뷰 과정을 거칠 수 있다. 즉, 사람이 읽는 문서와 AI 에이전트가 읽는 문서가 완전히 동일해지는 것이다.
이런 방식은 마크다운 기반의 사내 위키나 시스템 가이드 문서와 같은 형태로 이미 여러 환경에서 쓰이고 있다. 다만, 각 조직과 프로젝트의 필요에 맞춰 자체적인 규격으로 만들어진 탓에, 한 팀이 정리해 둔 지식을 다른 팀의 에이전트가 그대로 가져다 읽고 활용하기는 어렵다는 한계가 존재한다.
3. OKF: Google Cloud의 오프로딩 규격
OKF(Open Knowledge Format)는 Google Cloud가 2026년 6월 공개한 개방형 지식 규격이다. 서로 다른 환경에서 구축된 지식이라도 별도의 변환이나 번역 과정 없이 매끄럽게 주고받을 수 있도록 표준 형식을 정의한다.
본질적으로 OKF는 마크다운 파일이 담긴 디렉토리다. 무거운 런타임 환경이나 복잡한 벡터 DB, 별도의 SDK를 요구하지 않고, 오직 파일과 폴더로만 이루어져 있다. 순수한 마크다운 포맷이므로 어떤 텍스트 에디터에서든 쉽게 읽을 수 있고, 어떤 검색 도구로도 색인할 수 있다. 이 규격이 정하는 것은 오직 ‘파일의 구조’ 뿐이다. 따라서 지식을 생산하는 쪽과 지식을 소비하는 쪽이 시스템을 억지로 서로에게 맞출 필요가 없다.
| 구성 요소 | 상세 설명 | 대응되는 개념 |
| bundle | 개념 파일들이 모인 디렉토리 전체 | git 레포 또는 디렉토리 |
| concept | 마크다운 개념 파일. 경로가 곧 식별자가 되며 한 가지 개념의 모든 지식을 담는다 | 소스코드 파일 1개 |
| index.md | 디렉토리 안에 무엇이 있는지 링크와 한 줄 설명으로만 적은 진입점 파일 | README.md |
| frontmatter | 파일 상단 YAML 블록. 문서를 요약해 구조화할 필드가 들어가며 Type 필드로 문서 유형을 구분 | 코드 상단 주석 |
| link | 마크다운 문법을 따라 “[제목](주소)” 형태로 정의되는 다른 개념파일로 향하는 길 | 문서 간 상호 참조 |
표 1. OKF 구성 요소
정해진 구성 요소는 이것이 전부이며, 그 안에 기술되는 내용에는 어떠한 제약도 없다. 어떤 타입이 존재하는지, 어떤 필드를 포함할지, 본문에 어떤 내용으로 채울지는 전적으로 문서를 쓰는 쪽이 정한다.
실제 데이터베이스 조회 시나리오를 가정해 보면, 스키마는 테이블 개념 문서의 본문에, 계산식은 지표 개념 문서 안에 들어갈 수 있다. 구조화할 내용은 Frontmatter로 요약되고, 나머지는 전부 자유롭게 쓰인다.
문서가 늘어 길잡이가 필요해지면 index.md가 목차 역할을 한다. 에이전트는 하위 문서를 열기 전에 이 파일부터 읽기 때문에 여기 적힌 설명이 탐색의 방향을 정한다.
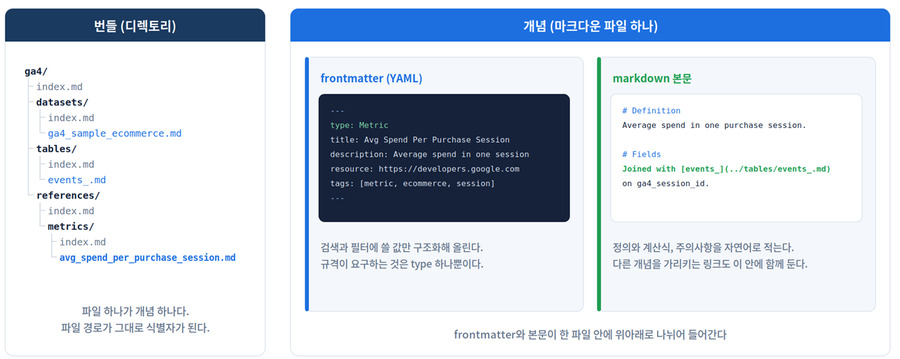
그림 1. OKF 번들의 구조
링크가 만드는 이동 경로
파일끼리는 마크다운 링크를 통해 서로를 참조한다. 마크다운 본문에 “이 테이블은 [customers](./tables/customers.md)와 customer_id로 조인한다”고 작성하면 앞의 링크는 다음 문서로 가는 경로가 되고 뒤의 문장은 그 경로의 설명이 된다. 관계를 맺기 위해 별도의 복잡한 스키마를 정의할 필요가 없다. 문서를 직관적인 파일끼리의 링크로 연결하는 방식 덕분에, 담을 수 있는 개념이 데이터 구조에만 한정되지 않는다. 외부 시스템의 호출 방법이나 장애 대응 절차와 같은 조직의 운영 지식 역시 하나의 개념 문서가 되어 서로 유기적인 링크로 이어진다.
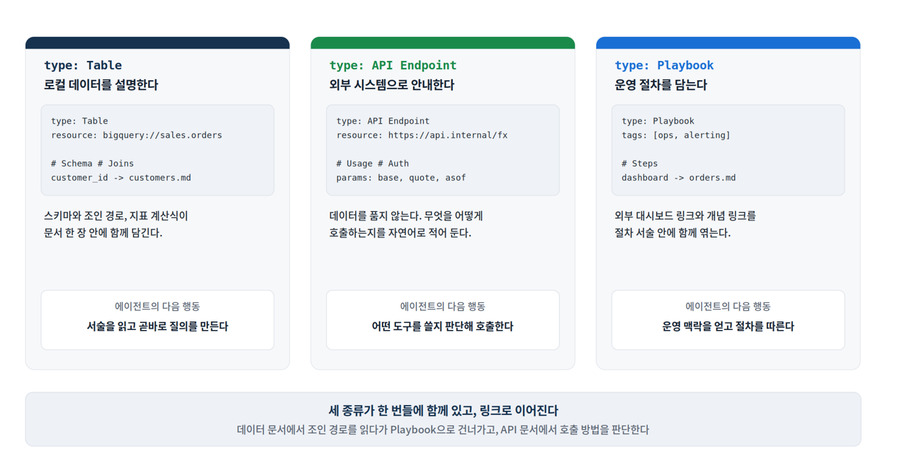
그림 2. 개념 파일의 세 가지 예시
번들을 쌓고 유지하는 방식
번들은 한 번에 완성되지 않는다. 조직이 가진 모든 테이블과 지표를 문서로 옮기는 작업은 방대한 시간이 소요되므로, 완벽하게 다 구축될 때까지 마냥 기다릴 수만은 없다. 그래서 OKF는 지식을 소비하는 쪽에도 규칙을 하나 두었다. 번들이 불완전하더라도 ‘아는 만큼만 최선을 다해 읽으라(best-effort)’는 것이다. 필드가 비어있으면 건너 뛰고, 깨진 링크는 무시하면 된다. 통신 프로토콜의 오랜 원칙인 “보낼 때는 엄격하게, 받을 때는 관대하게(Postel’s Law)”를 지식 처리 과정에 그대로 옮겨온 셈이다.
그렇기 때문에 처음부터 모든 것을 빈틈없이 채우지 않고도 바로 도입할 수 있다. 자주 쓰는 테이블을 먼저 문서화하고 조인 경로는 나중에 추가해도 된다. 지표 역시 필요한 만큼만 채워두고 실무 피드백을 거치며 점진적으로 보강하면 된다. 다만 소비 규칙이 관대한 만큼, 지식의 품질 자체를 시스템이 보장해 주지 않는다. 따라서 지식의 생명 주기 관리와 검수 과정은 별도의 프로세스로 엄격하게 관리해야 한다.
번들의 규모가 커지면 문서 탐색을 위한 검색 인덱스가 필요해질 수 있다. 이 부분은 시스템을 활용하는 쪽에서 자유롭게 결정한다. 실제 OKF의 한 참조 구현 사례를 보면, _meta/ 디렉토리 아래에 BM25 인덱스와 임베딩 벡터를 두고, 이를 검색하는 방법 자체를 하나의 개념 문서로 만들어 활용하기도 한다.
4. 담아 둔 지식을 읽는 방식: Agentic RAG
아무리 지식을 잘 정리해 두어도, 그것을 읽고 활용하는 방식이 과거에 머물러 있다면 아무런 소용이 없다. 단순히 검색한 결과를 프롬프트에 밀어 넣고 단편적인 답변을 만드는데 그친다면, 기껏 문서에 촘촘하게 적어 둔 링크는 무용지물이 되고 만다. 이제는 에이전트가 문서를 직접 열어 맥락을 파악하고, 다음에 어떤 정보를 탐색할지 스스로 판단하도록 만들어야 한다. 이처럼 단발성 검색으로 끝내지 않고, 에이전트의 주도적인 판단과 반복적인 탐색 과정을 얹은 진화된 방식을 Agentic RAG라고 부른다.
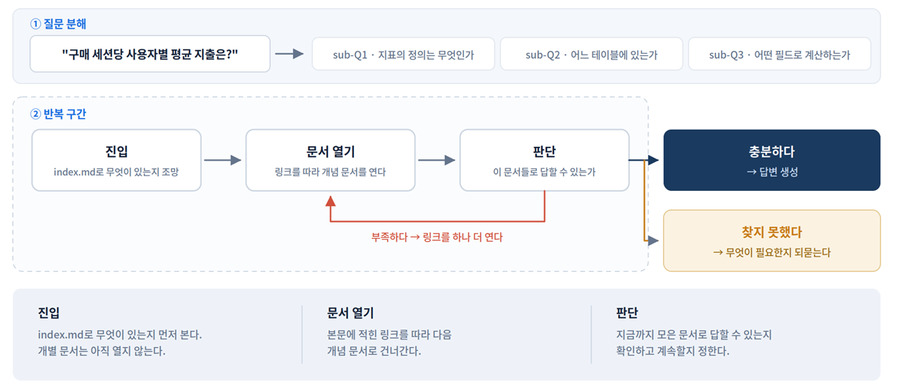
그림 3. Agentic RAG의 실행 루프
기존 방식과 달라지는 지점은 크게 네 가지다.
- 분해(Decomposition): 여러 의미가 얽혀 있는 복잡한 질문을 작고 명확한 단위로 쪼갠다. “지난 분기 지역별 매출 상위 고객”이라는 질문은 매출 지표, 지역 기준, 고객 식별 키를 묻는 세 가지 질문으로 나뉘며, 각각 독립적인 탐색 경로를 갖는다.
- 진입(Entry): 바로 개별 문서를 열어보기 전에 index.md를 확인해 어떤 지식이 있는지 큰 그림을 파악하고, 열어 볼 문서를 신중하게 판단한다.
- 이동(Navigation): 본문에 적힌 링크를 따라 다음 문서로 꼬리를 물며 건너간다. 단발성 검색만으로는 절대 얻을 수 없는 깊이 있는 문맥과 관계를 탐색할 수 있다.
- 판단(Evaluation): 지금까지 수집한 문서들로 완벽한 답변을 구성할 수 있는지 스스로 평가한다. 정보가 부족하다면 탐색을 이어가고, 충분하다고 판단하면 탐색을 멈춘다.
Agentic RAG는 탐색의 깊이를 미리 정해두지 않는다. 하나의 개념으로 충분한 질문이라면 한두 번의 탐색만으로 빠르게 멈추고, 여러 개념을 엮어야 하는 복잡한 질문이라면 필요한 만큼 깊이 파고든다. 만약 질문이 모호하거나 필요한 문서를 끝내 찾지 못했다면, 억지로 그럴싸한 오답을 지어내는 대신 무엇이 더 필요한지 질문자에게 정직하게 되묻는다.
또한, 문서가 아무리 늘어나도 에이전트의 출발점은 항상 같다. 개념 문서가 수백 개로 늘어나더라도 최상위 index.md에는 여전히 큰 분류 몇 갈래만 깔끔하게 남고, 구체적인 내용은 하위 디렉토리로 정리된다. 반면 벡터 인덱스에는 이런 ‘계층’의 개념이 잘 드러나지 않는다. 문서가 몇 개든 모든 조각이 동일한 평면상에 뿌려지고, 오로지 질문과의 단순 유사도만으로 순위를 매긴다. 이 때문에 지식의 규모가 커질수록 엇비슷한 파편들이 우후죽순 늘어나며, 정작 그중 무엇이 정답인지 가려낼 방법이 사라지게 된다.
5. 실제 번들에서 동작 확인하기
Google Cloud는 이해를 돕기 위해 참조 구현 형태의 샘플 번들을 함께 공개했다. 그중 구글 애널리틱스(Google Analytics) 데이터를 기반으로 구축된 번들을 살펴보며 개념 문서가 실제로 어떤 형태를 띠는지, 그리고 사용자의 질문 하나가 SQL 쿼리로 변환되기까지 어떤 과정을 거치는지 직접 따라가 본다.
원본은 Google 스토어의 접속과 구매 이벤트 기록을 BigQuery에 쌓아둔 3개월치 공개 데이터셋이다. 날짜마다 이벤트 테이블이 개별적으로 생성되고, 하나의 필드 안에 여러 하위 필드가 중첩(Nested)되어 있는 복잡한 구조라 단순히 스키마만 봐서는 데이터를 어떻게 집계해야 할지 막막하다. 세션당 지출을 어떤 단위로 묶어 계산할지, 구매가 발생하지 않은 세션도 계산에 넣어야 할지, 환불 내역은 어느 컬럼을 기준으로 반영할지 등 조직이 암묵적으로 정해 둔 비즈니스 로직은 데이터베이스의 어떤 필드에도 명시되어 있지 않기 때문이다.
여기서 지식 오프로딩은 두 단계로 이루어진다. 첫 번째는 BigQuery에서 직접 스키마와 필드 설명을 읽어 기본 테이블 문서를 생성한다. 이 과정을 거치면 날짜 별로 파편화된 수백 개의 테이블이 명확한 생성 규칙을 품은 단 하나의 개념 문서(tables/events_.md)로 정리된다. 두 번째는 구글 애널리틱스 공식 문서 등 권위 있는 외부 자료를 검색해, 지표의 정확한 정의와 인용 출처, 조인 경로 등 비즈니스 맥락을 문서에 덧붙이는 단계다. 즉, 시스템에서 자동으로 추출할 수 있는 물리적인 정보와 외부 검색으로 보완해야 하는 맥락적 지식을 두 단계로 나누어 구축하는 것이다.
이렇게 완성된 문서가 어떤 모습일지, 원래의 형식은 그대로 유지한 채 이해하기 쉽게 한글로 재구성해 보면 다음과 같다.
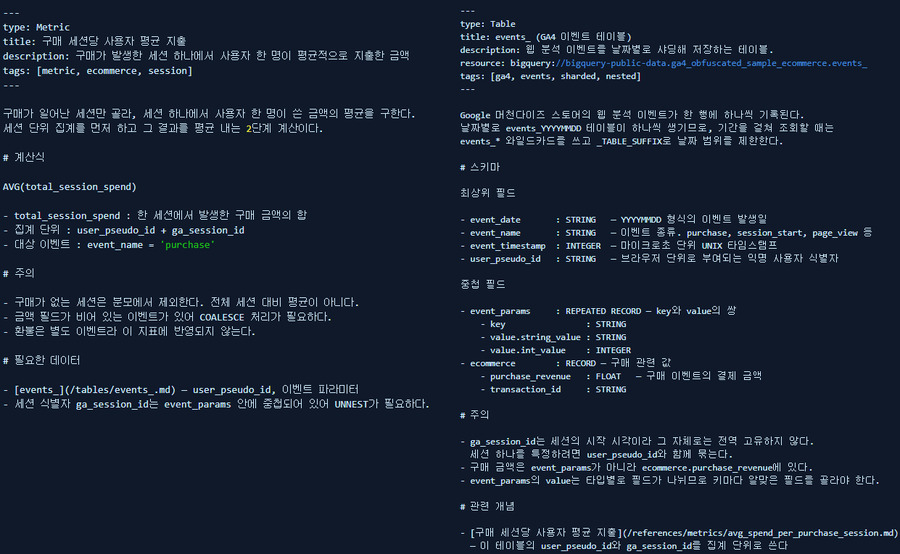
그림 4. 지표 및 테이블 개념 문서 예시
하나의 파일 안에 개념의 정의부터 계산식, 필드 정보, 인용 출처, 그리고 에이전트가 주의해야 할 사항까지 모두 함께 담겨 있다. 만약 기존 RAG 방식처럼 문서를 기계적으로 잘라냈다면, 긴 문서 곳곳에 파편화되어 뿔뿔이 흩어졌을 내용이다. 또한 문서들은 마크다운 링크를 통해 유기적으로 연결되어 있어, 필요할 때마다 한 문서에서 다른 문서로 자연스럽게 탐색을 이어갈 수 있는 구조다.
여기에 “구매 세션당 사용자들이 평균 얼마를 쓰는가?”라는 질문을 던져 본다.
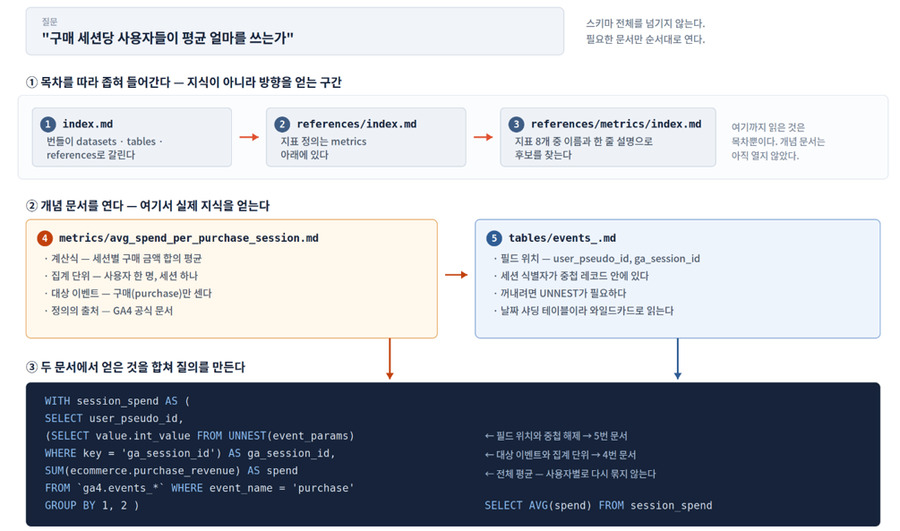
그림 5. 질문 하나가 SQL이 되기까지
에이전트의 탐색 경로는 크게 두 구간으로 나뉜다. 첫 번째 구간에서는 디렉토리를 따라 내려가며 전체적인 구조와 목차를 탐색한다. index.md를 보며 이 디렉토리 안에 무엇이 담겨 있는지, 각 항목은 어떤 내용을 뜻하는지 간단한 설명을 읽고 다음에 탐색할 방향을 결정한다.
방향을 확정하면 실제 문서를 연다. 우선 ‘지표 문서’를 열어 계산식과 집계 단위, 대상 이벤트와 정의의 출처를 확보한다. 이어서 링크를 따라 ‘테이블 문서’로 넘어가, 앞서 찾은 계산식에 필요한 필드가 어디에 있고, 복잡하게 중첩된 데이터 구조는 어떻게 풀어야 하는지에 대한 구체적인 해법을 얻어낸다.
이제 두 문서에서 수집한 퍼즐 조각들이 하나로 합쳐진다. ‘무엇을 평균 낼 것인가’와 ‘어느 이벤트를 셀 것인가’는 지표 문서에서, ‘어떤 값으로 집계하고 필드의 중첩을 어떻게 풀 것인가’는 테이블 문서에서 완벽하게 파악했다. 에이전트는 질문에 답하기 위한 모든 단서를 얻어 냈다고 판단했고, 최종 결과물인 SQL을 생성한다.
이 과정을 통해 중요한 사실을 하나 알 수 있다. AI 모델이 답변을 내지 못했던 진짜 이유는 ‘SQL 문법을 몰라서’가 아니었다. 정작 몰랐던 것은 ‘어느 테이블과 컬럼을 골라야 하는지’, ‘이 지표를 어떤 식으로 계산하는 것이 해당 조직의 합의된 기준인지’ 였다. 이런 고유한 비즈니스 문맥은 모두 문서로 명확하게 남길 수 있고, 각 지식이 독립된 파일로 관리되면 에이전트는 필요할 때 언제든 찾아 쓸 수 있다.
6. 벡터 기반 RAG와의 차이점
| 분류 | 벡터 기반 RAG | OKF + Agentic RAG |
| 지식 생산 | 원문을 넣으면 자동으로 분할(chunking) 되어 저장. 초기 구축 비용이 낮음. | 개념 단위로 작성하고 검수해야 함. 초기 구축 비용이 존재함. |
| 잘 맞는 지식 | 로그, 회의록, 처리 이력 등 개념의 경계가 흐린 대량의 자유 텍스트 | 경계가 뚜렷한 스키마, 지표, 절차 등 구조화 가능한 지식 |
| 변경 반영 | 문서 수정 후 재임베딩 및 배치(Batch) 작업 필요 | 파일 수정 후 PR(Pull Request) 병합(Merge) |
| 변경 이력 | 인덱스의 변경 사항을 diff로 직관적으로 확인하기 어려움 | 파일 diff와 log를 통해 누가, 언제, 왜 바꿨는지 추적 가능 |
| 임베딩 모델 교체 | 인덱스 전체를 재연산하고 다시 검증 | 지식(원본 파일)은 유지한 채 인덱스만 필요시 재생성 |
| 재사용·배포 | 인덱스 접근 권한과 스키마 합의가 선행 | 지식 디렉토리 자체를 clone 하여 재사용 |
| 평가 정답셋 | chunk 분할 기준이 바뀔 때마다 정답의 위치가 흔들림 | 파일 경로 단위로 정답 위치가 명확하게 고정 |
| 질의당 비용 | 한 번 검색으로 완료되어 지연(Latency) 예측이 용이함 | 여러 홉(Multi-hop)을 탐색하는 경우 호출 횟수와 지연 시간이 증가 |
표 2. 운영 관점 비교
OKF는 초기 지식 구축 단계에서 일정 수준의 비용과 수고가 발생하지만, 이후의 유지보수, 검수, 그리고 지식을 자산화하는 과정에서 그 비용을 충분히 회수하는 구조다.
이는 모든 지식이 명시적인 ‘파일’ 형태로 남아있기 때문에 가능한 일이다. 문서를 수정하는 작업은 코드처럼 PR을 올리고 병합하는 것으로 끝나며, 무엇을 언제 왜 바꾸었는지 그 변경 이력이 고스란히 남는다. 임베딩 모델을 교체하더라도 원본 지식은 건드릴 필요 없이 인덱스만 다시 만들면 그만이다. 다른 팀과 지식을 공유할 때도 복잡한 스키마 합의 없이 디렉토리만 통째로 넘겨주면 된다.
에이전트의 성능을 평가할 때도 훨씬 직관적이다. 정답을 단순히 텍스트가 아닌 ‘파일 경로’로 지정해 둘 수 있기 때문이다. 앞서 예로 든 “구매 세션당 평균 지출”을 묻는 질문이라면, 에이전트가 지표 문서와 테이블 문서 두 개를 정확히 읽어냈는지 경로 탐색 로그만 확인하면 된다. 만약 답변이 틀렸다면, 에이전트가 아예 문서를 찾지 못한 것인지, 아니면 문서는 다 찾아 놓고도 SQL 문법을 잘못 작성한 것인지 원인을 분리하여 정확하게 평가할 수 있다.
물론 이런 방식에도 명확한 한계는 존재한다. 꼬리를 무는 여러 번의 탐색을 거쳐 답변을 생성하므로 LLM 호출 횟수가 늘어나고, 응답 시간(Latency)을 예측하기도 상대적으로 어렵다. 또한 세상의 모든 지식이 이 형식에 들어맞는 것도 아니다. 시스템 로그나 일상적인 채팅 기록처럼 개념의 경계 자체가 흐릿한 텍스트는 파일 하나로 정의하기 매우 까다롭다. 따라서, 데이터베이스 스키마나 핵심 비즈니스 지표처럼 경계가 뚜렷한 지식은 먼저 OKF로 정의하여 오프로딩하고, 나머지 유동적인 텍스트 데이터는 기존의 벡터 검색 방식을 병행해 활용하는 것이 가장 현실적이고 효율적인 접근이다.
마치며
에이전트가 틀린 답을 낼 때, 그 원인이 늘 AI 모델의 성능에만 있는 것은 아니다. 에이전트가 참조해야 할 복잡한 비즈니스 로직이나 명확한 판단 기준을 제공하지 않는다면, 에이전트 역시 올바른 정답을 알아낼 방법이 없다. 아무리 뛰어난 추론 능력을 갖춘 AI라도, 주어지지 않은 ‘조직의 고유한 맥락’까지 스스로 지어낼 수는 없기 때문이다.
OKF는 이러한 지식을 ‘어디에, 어떤 형태로 적어둘지’를 명확히 정의하고, Agentic RAG는 그렇게 적어둔 지식을 ‘필요한 만큼 스스로 찾아 읽게’ 만든다. 지식의 형식만 갖추고 읽는 방식이 과거에 머무른다면 기껏 연결한 링크를 따라갈 일이 없고, 반대로 읽는 방식만 최신으로 바꾼다면 애초에 에이전트가 따라갈 링크 자체가 존재하지 않게 된다. 두 가지가 반드시 맞물려야 하는 이유다.
따라서 새로운 도구를 도입하기 전에, 우리 조직의 어떤 유스케이스가 이 형태에 어울리는지부터 냉정하게 따져봐야 한다. 환각(Hallucination) 발생 시 비즈니스적 타격이 크고 전사적으로 합의된 기준이 필요한 ‘엔터프라이즈 통합 검색’이나 ‘경영 의사결정 지원 시스템’에는 지식 오프로딩을 우선적으로 적용하는 것이 유리하다. 반면, 일반적인 고객 문의 접수나 대화형 챗봇처럼 문맥의 경계가 유동적이고 정형화하기 어려운 서비스는 기존의 벡터 검색 방식을 유지하는 것이 더 효율적이다.
적용 범위를 정하고 나면 시작은 그리 어렵지 않다. 기존 시스템 자산에서 초안을 추출하고, 거기에 조직 내부의 합의된 맥락을 덧붙이면 곧바로 첫 번째 지식 번들이 만들어진다. 이후 실무에서 필요한 지식들을 문서에 차곡차곡 쌓아 나가며 우리 조직만의 견고한 지식 체계를 완성할 수 있다. 빠르게 변화하는 AI 생태계 속에서 모델과 에이전트는 앞으로도 끊임없이 교체될 것이다. 기술 트렌드가 바뀔 때마다 시스템을 처음부터 다시 구축하는 낭비를 막으려면, 정제된 지식을 모델 바깥의 독립적인 ‘자산(Asset)’으로 단단하게 남겨 두어야 한다.
# References
[1]: GoogleCloudPlatform/knowledge-catalog, GitHub, https://github.com/GoogleCloudPlatform/knowledge-catalog
[2]: How the Open Knowledge Format can improve data sharing, Google Cloud Blog, https://cloud.google.com/blog/products/data-analytics/how-the-open-knowledge-format-can-improve-data-sharing
[3]: BigQuery Export advanced queries, Google Analytics Developers, https://developers.google.com/analytics/bigquery/advanced-queries
[4]: Google Cloud Introduces Open Knowledge Format (OKF), MarkTechPost, https://www.marktechpost.com/2026/06/16/google-cloud-introduces-open-knowledge-format-okf-a-vendor-neutral-markdown-spec-for-giving-ai-agents-curated-context/
[5]: Google Cloud's Open Knowledge Format turns scattered docs into markdown files for AI agents, The Decoder, https://the-decoder.com/google-clouds-open-knowledge-format-turns-scattered-docs-into-markdown-files-for-ai-agents/
방태연 프로
소프트웨어사업부 플랫폼개발팀
에스코어에서 AI Agent와 Agent 플랫폼을 개발하고 있습니다.
Register for Download Contents
- 이메일 주소를 제출해 주시면 콘텐츠를 다운로드 받을 수 있으며, 자동으로 뉴스레터 신청 서비스에 가입됩니다.
개인정보 수닙 및 활용에 동의하지 않으실 경우 콘텐츠 다운로드 서비스가 제한될 수 있습니다.
파일 다운로드가 되지 않을 경우 s-core@samsung.com으로 문의 주십시오.