들어가며
RabbitMQ는 Queue 타입으로 Classic Queue와 Quorum Queue를 제공한다. Classic Queue는 빠르고 효율적이지만, 4.0부터는 여러 노드에 복제되지 않는다. 반면 Quorum Queue는 Raft 합의 알고리즘으로 여러 노드에 동기 복제하여 데이터 일관성을 보장한다.
금융 결제 시스템을 예로 들면, 메시지 유실은 주문 미처리로, 중복 처리는 이중 결제로 이어진다. 이런 환경에서는 Classic Queue의 비동기 복제보다 Quorum Queue의 강력한 일관성 보장이 필요하다.
1.1. 아쉬운 점이 있었다
RabbitMQ 4.0 이전 Quorum Queue에는 치명적인 단점이 있었다. 메시지 우선순위 기능이 없었기 때문이다.
우선순위가 필요한 실무 상황은 다양하다.
아래 항목을 통해 좀더 상세한 실무의 상황을 살펴보자.
- 전자상거래: VIP 주문을 일반 주문보다 먼저 처리해야 하지만, 일반 주문 1,000개가 쌓여 있으면 VIP 주문도 뒤에서 기다려야 했다.
- 모니터링: Critical 알람은 즉시 발송해야 하지만, Warning 알람 뒤에서 대기하는 상황이 발생했다.
- 배치 시스템: 긴급 리포트 요청이 정기 배치 뒤에서 처리되는 문제가 있다.
결과적으로 팀들은 선택을 강요받았다.
- 고가용성 필요 → Quorum Queue 사용, Priority 포기
- Priority 필요 → Classic Queue 사용, 데이터 일관성 위험 감수
1.2. RabbitMQ 4.0: 드디어 해결되다
RabbitMQ 4.0은 Quorum Queue에 Priority 기능을 추가하여 이 딜레마를 해결했다. 같은 4.0에서 Classic Queue Mirroring이 제거되면서, 복제와 우선순위를 함께 쓰려면 Quorum Queue 외에 선택지가 없어졌다. Quorum Queue Priority는 High와 Normal을 2:1 고정 비율로 소비한다. 낮은 우선순위 메시지의 처리량 하한이 명시적으로 보장된다는 뜻이다.
이 글은 RabbitMQ 4.0 Quorum Queue Priority의 동작 방식과 200,000개 메시지 실측 테스트 결과를 다룬다.
2. 배경: 왜 Quorum Queue인가
2.1. Classic Queue 복제가 사라지다
RabbitMQ 3.x까지는 Classic Queue에 Mirroring을 설정해 여러 노드에 복제할 수 있었다. 이 기능은 2021년 deprecated되었고, 4.0에서 완전히 제거되었다.
4.0부터 Classic Queue는 하나의 노드에만 존재한다. 그 노드가 내려가면 큐도 함께 사용할 수 없다. 4.x에서 메시지를 복제하려면 Quorum Queue나 Stream을 사용해야 한다.
2.2. Quorum Queue: Raft 합의로 일관성을 보장하다
Quorum Queue는 Raft 합의 알고리즘으로 동작한다. 과반수 노드가 기록을 확인해야 커밋이 완료된다. 네트워크 파티션이 발생하면 과반수를 유지한 쪽만 동작한다. 두 그룹이 동시에 Leader 역할을 하는 Split-brain은 구조적으로 발생하지 않는다.
Publisher Confirm을 받은 메시지는 과반수 노드가 살아 있는 한 유실되지 않는다.
| 항목 | Classic Queue(4.x) | Quorum Queue(4.0~4.2) |
| 복제방식 | 없음 (Mirroring 4.0에서 제거) | Raft 합의 (동기) |
| 노드 장애 시 | 해당 큐 사용 불가 | 과반수 유지 시 계속 동작 |
| Priority 단계 | 최대255(한 자릿수 권장) | 2단계(Normal/High) |
| Priority 설정 | x-max-priority 필수 | 별도 설정 불필요 |
| Priority 소비 방식 | 우선순위 높은순 | 2:1 비율 혼합 |
| 낮은 우선순위 처리 비율 | 정의되지 않음 | 1/3 보장 |
| Starvation | 발생가능 | 방지됨 |
3. Classic Queue Priority의 특성
Classic Queue는 우선순위마다 내부 sub-queue를 둔다. 한 전달 사이클에서 가장 높은 sub-queue부터 가장 낮은 sub-queue까지 차례로 비운다.
사이클 도중 들어온 높은 우선순위 메시지는 다음 사이클로 넘어간다. 공식 문서는 이 방식으로 Starvation을 막는다고 설명한다.
다만 낮은 우선순위가 어떤 비율로 처리되는지는 정의되어 있지 않다. 낮은 우선순위의 처리량을 설계 기준으로 삼기 어렵다.
운영 측면에서 주의할 점도 있다.
- TTL: 만료는 큐 head에서만 일어난다. 만료된 낮은 우선순위 메시지가 높은 우선순위 메시지 뒤에 남아 통계에 계속 잡힌다.
- max-length: 한도를 넘으면 head부터 버린다. 높은 우선순위 메시지가 먼저 버려질 수 있다.
- 리소스: 단계마다 sub-queue를 유지하므로 단계가 많을수록 CPU와 메모리를 더 사용한다.
무엇보다 4.x의 Classic Queue는 복제되지 않는다. 우선순위를 얻는 대신 고가용성을 포기해야 한다.
4. Quorum Queue의 새로운 접근
4.1. 동작 메커니즘
RabbitMQ 4.0 Quorum Queue는 Fixed Ratio Scheduling(고정 비율 스케줄링) 방식을 도입했다. High 2개와 Normal 1개를 순차적으로 소비하여 낮은 우선순위도 주기적으로 처리되도록 보장한다.
소비 패턴
High → High → Normal → High → High → Normal → ...
(2:1 비율 유지)
우선순위는 메시지 Priority 값에 따라 자동 분류된다.
Priority 0-4 : Normal
Priority 5-9 : High
Priority 미지정: Normal (기본값 4)
Queue 타입을 quorum으로 지정하기만 하면 Priority 기능이 자동으로 활성화된다. 별도 인자가 필요 없다.
4.2. 왜 2:1 비율인가?
공식 문서는 2:1을 택한 이유를 밝히지 않는다. 필자는 이 비율을 두 요구의 절충으로 본다. 너무 높은 비율(10:1)은 높은 우선순위의 의미를 희석시키고, 너무 낮은 비율(1.5:1)은 낮은 우선순위 메시지를 과도하게 처리한다. 2:1은 높은 우선순위를 2배 빠르게 처리하면서도 낮은 우선순위가 완전히 방치되지 않는 균형점이다.
(RabbitMQ 4.3 변경사항: RabbitMQ 4.3부터 이 2:1 비율 방식은 폐지되고, 32단계(0-31) Strict Priority로 전환되었다. 절대적 우선순위가 필요하다면 4.3 이상을 검토할 수 있으나, Starvation 방지는 별도 설계가 필요하다.)
5. 실전 테스트
5.1. 테스트 환경 구성
다음 환경에서 테스트를 수행했다.
소프트웨어
- RabbitMQ 4.2.1
- Docker 컨테이너
- Python 3.11
- pika 1.3.2
하드웨어
- CPU: i7-8700
- RAM: 16GB
- 네트워크: 동일 호스트 내 loopback (localhost)
5.2. 소규모 테스트 (20개 메시지)
먼저 Normal 10개와 High 10개, 총 20개 메시지로 기본 동작을 테스트한다.
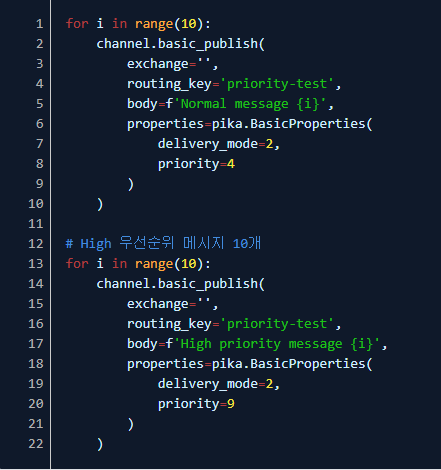
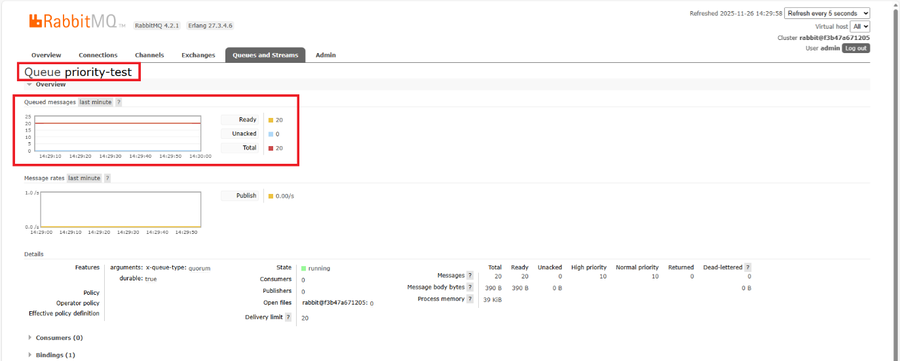
그림 1. UI에서 20개 메시지 대기 중
5.3. 소비 패턴 확인
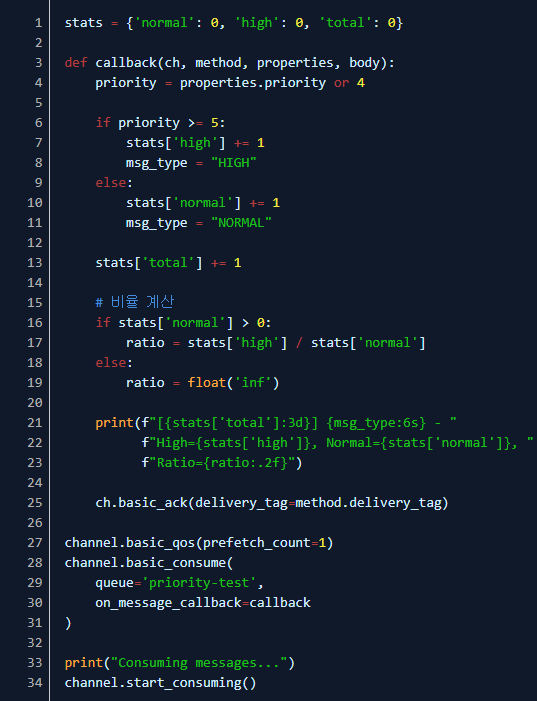
Consumer를 실행하여 2:1 비율 유지 여부를 검증한다.
5.4. 20개 메시지 테스트 결과
실제 소비 결과다.
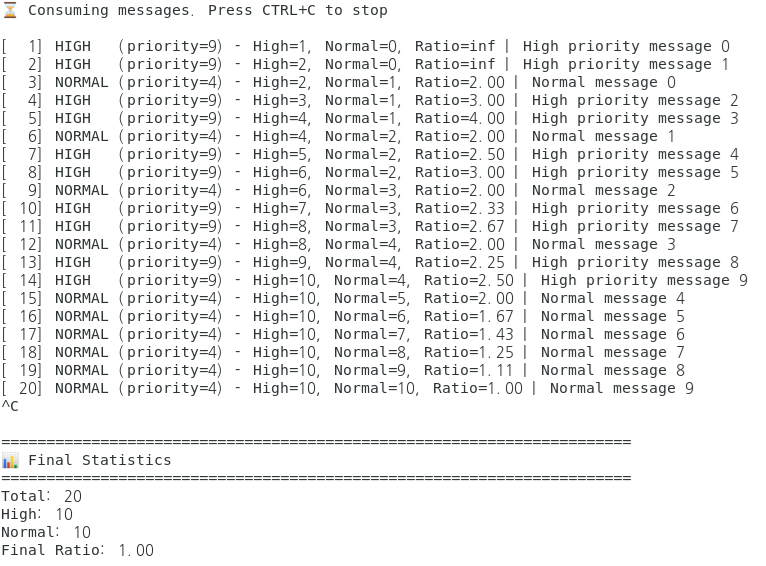
그림 2. 20개 메시지 소비 로그 – 2:1 비율 확인
메시지 3, 6, 9, 12, 15번에서 정확히 2:1 비율을 유지한다.
High 메시지가 모두 소비된 후(16-20번)에는 Normal 메시지만 소비되어 최종 비율은 1:1이 되었다.
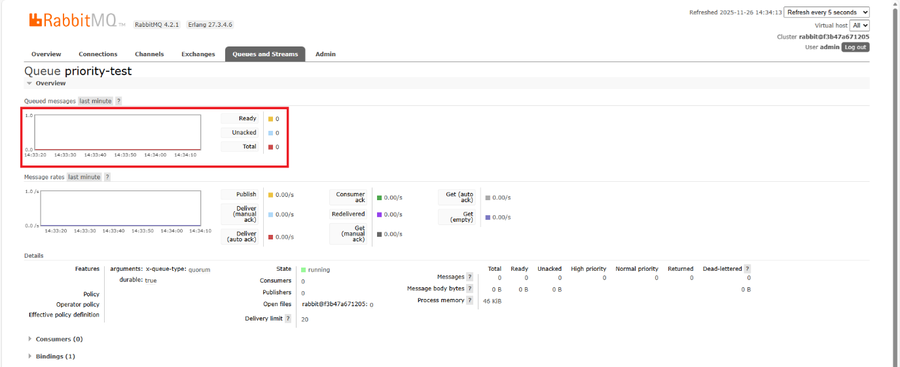
그림 3. 소비 완료 후 Queue 상태 – Ready = 0
5.5. 대규모 테스트 (200,000개 메시지)
운영 환경을 시뮬레이션하기 위해 Normal 100,000개와 High 100,000개, 총 200,000개 메시지로 대규모 테스트를 수행했다.
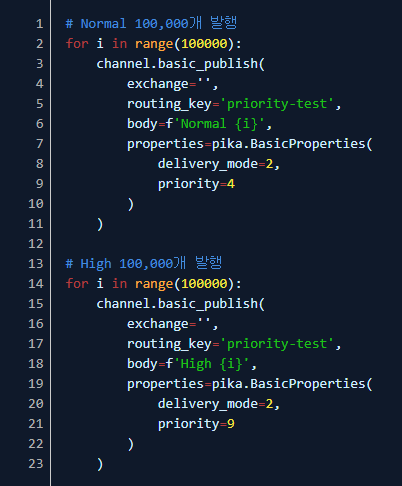
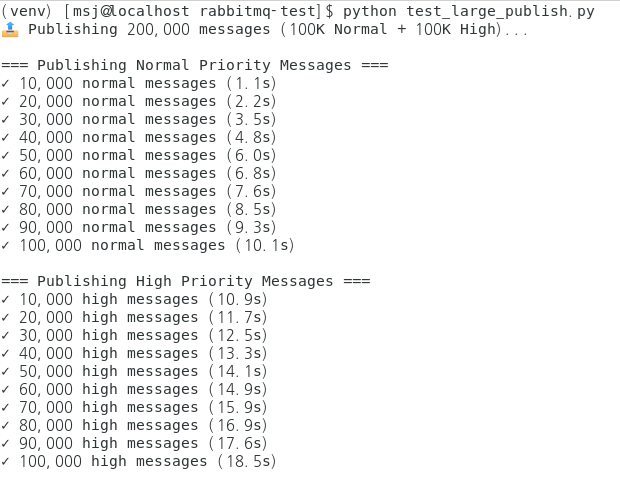
그림 4. 200,000개 메시지 발행
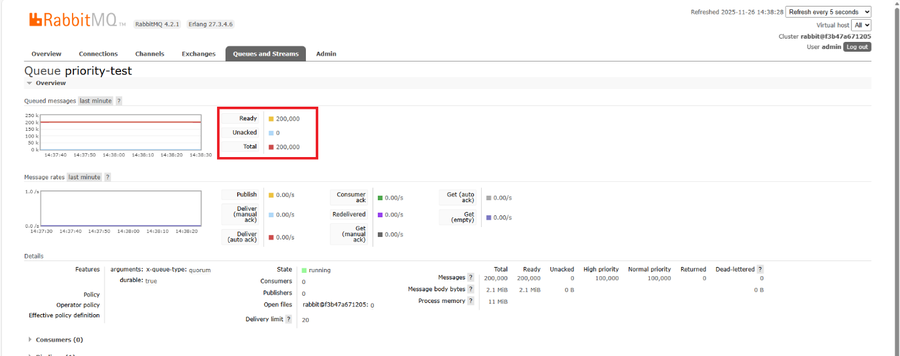
그림 5. Management UI – 200,000개 메시지 대기 중
5.6. 200K 메시지 소비 결과
1,000개마다 누적 소비 비율을 측정하여 안정성을 확인했다.
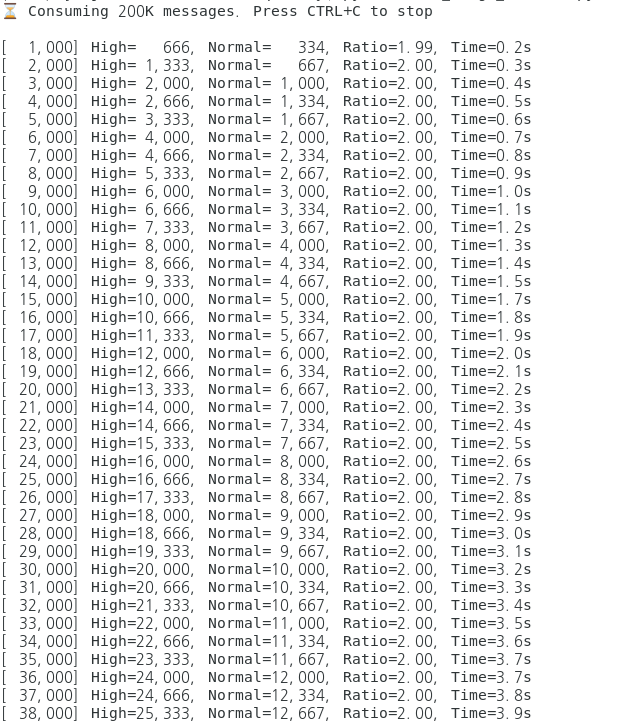
그림 6. 200,000개 메시지 소비 로그 – 일관된 2:1 비율 유지
대규모 환경에서도 정확히 2:1 비율을 유지하며 소비되었다. High 메시지가 모두 소비된 후(150,000번 이후)에는 Normal 메시지만 소비되어 최종 비율은 1:1이 되었다.
5.7. 소비 패턴 시각화
200,000개 메시지의 소비 패턴을 그래프로 시각화했다.
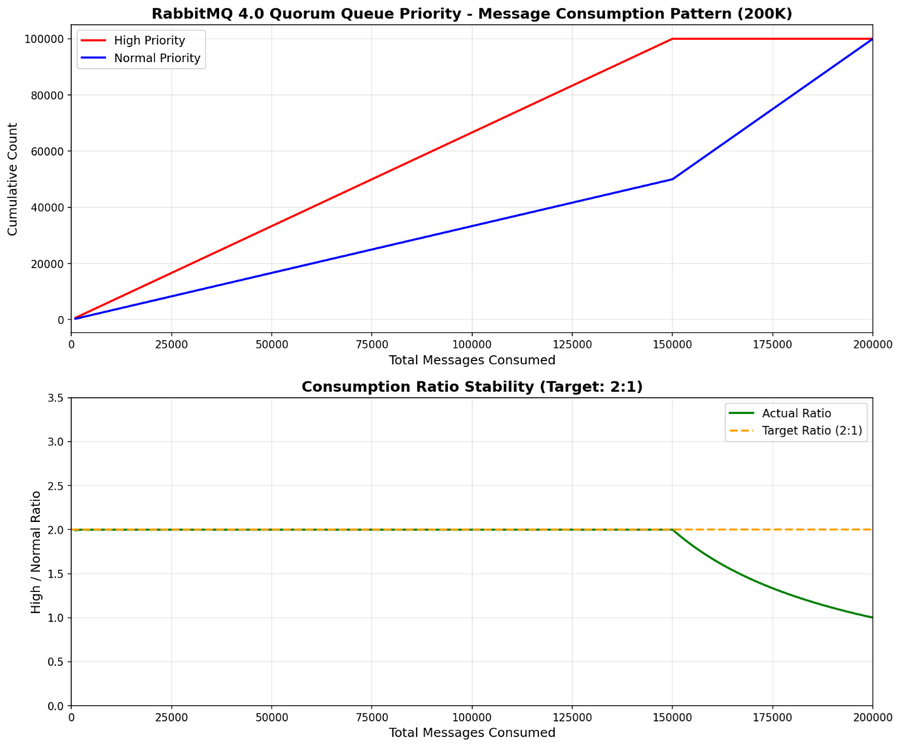
그림 7. 그래프 1 (상단): High와 Normal 메시지의 누적 소비 패턴 – High는 기울기 2배로 증가 / 그래프 2 (하단): 소비 비율 변화 – 목표 비율 2:1(주황 점선)을 일관되게 유지
상단 그래프에서 High 메시지(빨강)는 Normal 메시지(파랑)보다 약 2배 빠르게 증가한다.
하단 그래프는 실제 소비 비율(초록)이 목표 비율 2:1(주황 점선)을 대부분의 구간에서 유지한다.
분석 결과, 전체 샘플의 약 74%가 1.9-2.1 범위 내에서 2:1 비율을 유지했다.
6. 언제 사용하는가?
| 요구사항 | Quorum Priority | 큐 분리 | Classic Priority |
| 절대적 우선순위 | △ (2:1 비율) | ✅ | ✅ |
| 고가용성 | ✅ (Raft) | ✅ | ❌ 복제없음 |
| Starvation 방지 | ✅ (자동) | ○ | ❌ |
| 관리 복잡도 | ✅ 낮음 | △ 높음 | ✅ 낮음 |
| 처리량 | ○ 중간 | ○ 중간 | ✅ 높음 |
| 우선순위 | ❌ 2단계 | ✅ | ✅ 255단계 |
Quorum Priority가 적합한 경우
- VIP 주문을 먼저 처리하되, 일반 주문도 방치하면 안 되는 경우
- 고가용성과 우선순위를 동시에 확보해야 하는 경우
- 큐 관리 복잡도를 낮추고 싶은 경우
큐 분리가 더 나은 경우
- 금융 결제처럼 절대적 우선순위가 필요한 경우
- 3단계 이상 우선순위가 필요한 경우
- 처리 비율을 동적으로 조정해야 하는 경우
Classic Priority를 유지해야 하는 경우
- 단일 노드 환경이거나 약간의 메시지 유실이 허용되는 경우
- 최대 처리량이 최우선인 경우
7. 제약사항
- 우선순위 2단계 제한: Normal/High만 지원. 3단계 이상이 필요하면 큐 분리 필요
- 2:1 비율 고정: 피크 시간대 동적 조정 불가
- 성능 오버헤드: Raft 합의 + Priority 스케줄링으로 Classic Queue 대비 처리량 감소
- 디스크 관리: Raft 로그 순차 저장 특성상 Normal 메시지가 쌓이면 디스크 사용량 지속 증가. TTL 설정과 모니터링 필수
- 버전 요구사항: RabbitMQ 4.0 이상 필요
마치며
RabbitMQ 4.0 Quorum Queue Priority는 고가용성과 우선순위 처리라는 두 요구사항을 하나의 큐에서 해결하면서, 2:1 고정 비율로 낮은 우선순위의 처리량 하한을 보장한다. 200,000개 메시지 테스트에서 74%의 샘플이 1.9-2.1 범위를 유지하며 설계 의도대로 동작함을 확인했다.
단, 2단계 우선순위 제한과 고정된 2:1 비율, 디스크 관리 이슈는 도입 전 반드시 검토해야 할 트레이드오프다. “VIP를 먼저 처리하되 일반도 방치하면 안 된다”는 요구사항이라면 Quorum Queue Priority가 좋은 선택지다. 절대적 우선순위나 세밀한 제어가 필요하다면 큐 분리 방식이 더 적합하다.
# References
[1]: RabbitMQ 4.0 공식 블로그: https://www.rabbitmq.com/blog/2024/08/28/quorum-queues-in-4.0
[2]: Quorum Queue 공식 문서: https://www.rabbitmq.com/docs/quorum-queues
[3]: Priority Queue 공식 문서: https://www.rabbitmq.com/docs/priority
장민석 프로
소프트웨어사업부 플랫폼개발팀
삼성그룹의 메일엔진 개발을 담당하고 있습니다.
Register for Download Contents
- 이메일 주소를 제출해 주시면 콘텐츠를 다운로드 받을 수 있으며, 자동으로 뉴스레터 신청 서비스에 가입됩니다.
개인정보 수닙 및 활용에 동의하지 않으실 경우 콘텐츠 다운로드 서비스가 제한될 수 있습니다.
파일 다운로드가 되지 않을 경우 s-core@samsung.com으로 문의 주십시오.